CASE STUDY • KUBERNETES • MULTI-CLUSTER
Kubernetes Multi-Cluster com Karmada: Failover, Recovery e Workload Rebalancing
Laboratório prático para validar distribuição de workloads, resiliência entre clusters Kubernetes e recuperação de aplicações utilizando Karmada.
01
Contexto
Ambientes Kubernetes distribuídos entre múltiplos clusters introduzem desafios relacionados a scheduling, disponibilidade, recuperação de falhas e redistribuição de workloads.
Este laboratório foi criado para validar, de forma prática, o comportamento do Karmada na administração centralizada de workloads executados em dois clusters Kubernetes independentes.
Validar como uma aplicação distribuída entre dois clusters Kubernetes se comporta durante a indisponibilidade de um dos clusters, preservando as réplicas e permitindo sua recuperação após o retorno do ambiente.
02
Objetivo
Demonstrar o ciclo completo de uma aplicação multi-cluster: distribuição inicial, indisponibilidade de um cluster, failover para o cluster saudável, recuperação e posterior rebalanceamento das réplicas.
Scheduling
Distribuir as réplicas da aplicação entre os clusters Kubernetes registrados no Karmada.
Failover
Validar a redistribuição das réplicas quando um dos clusters fica indisponível.
Recovery
Recuperar o cluster e validar seu retorno ao estado saudável dentro da arquitetura multi-cluster.
Rebalancing
Rebalancear novamente o workload após a recuperação do ambiente.
03
Arquitetura
O ambiente utiliza um Karmada Control Plane responsável pelo gerenciamento centralizado de dois clusters Kubernetes independentes, registrados como member clusters em Push Mode.
O Karmada mantém a definição do workload e utiliza políticas de propagação para determinar como as réplicas devem ser distribuídas entre os clusters disponíveis.
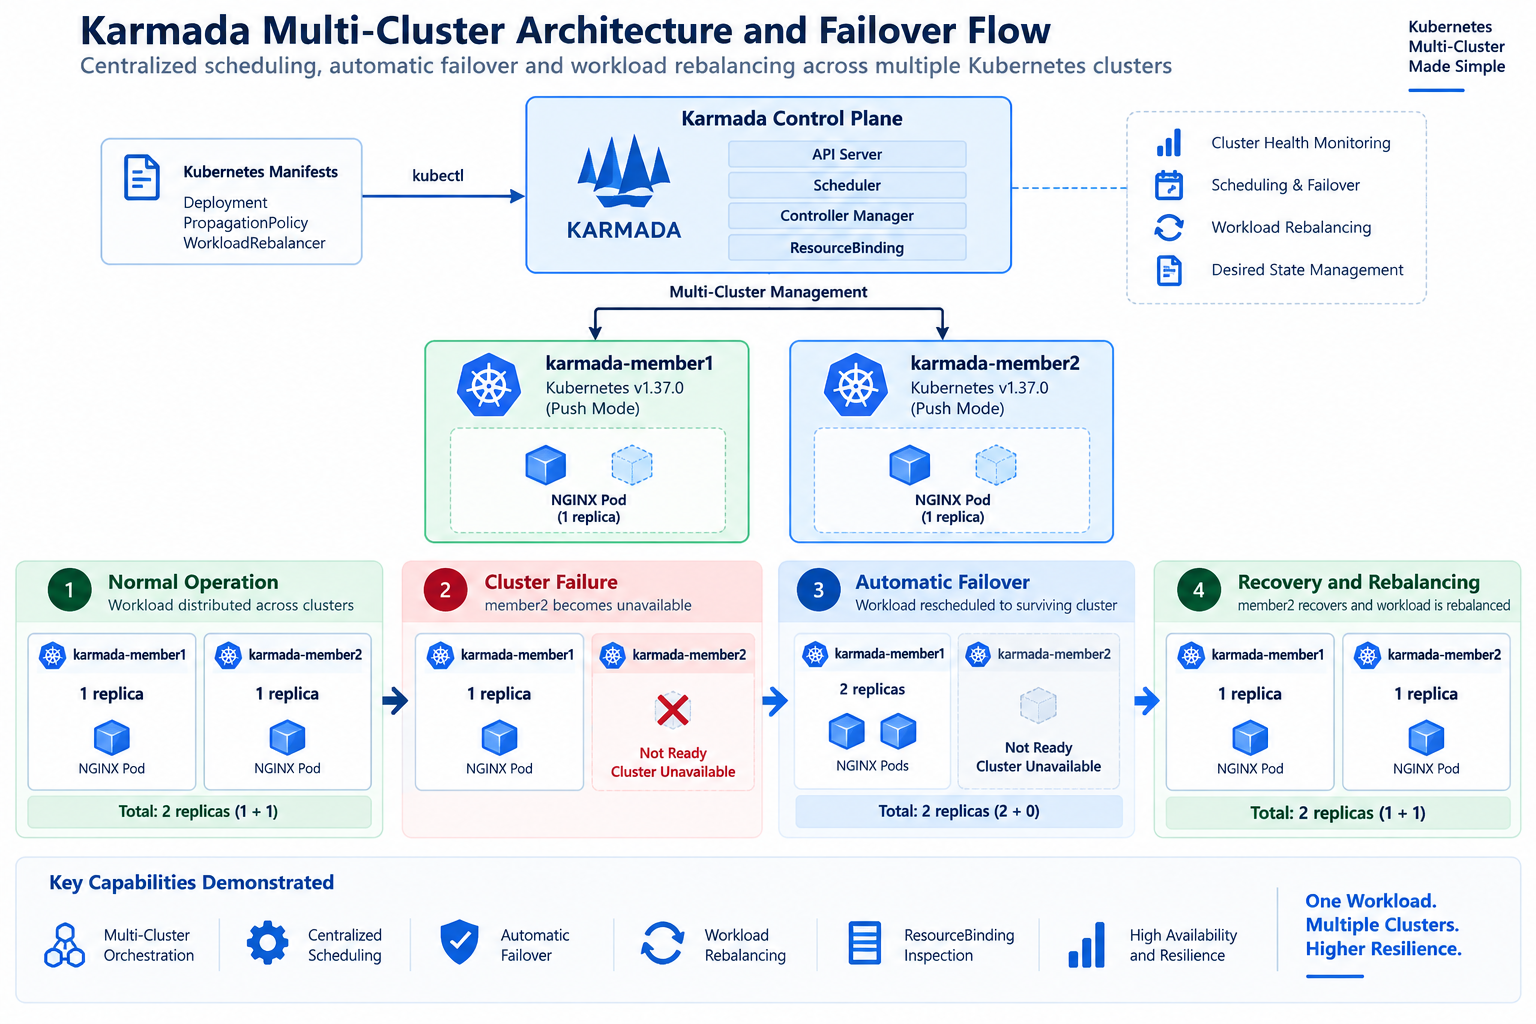
Centraliza o gerenciamento, scheduling e propagação dos workloads entre os clusters Kubernetes.
Primeiro cluster Kubernetes utilizado para execução das réplicas distribuídas pelo Karmada.
Segundo cluster Kubernetes utilizado para validar indisponibilidade, failover e recuperação.
Define como o workload é propagado e como suas réplicas são distribuídas entre os member clusters.
Representa a decisão de scheduling do Karmada e registra a distribuição das réplicas entre os clusters.
Permite recalcular a distribuição após a recuperação de um cluster e restaurar o estado desejado.
O workload permanece definido de forma centralizada no Karmada. Os member clusters funcionam como destinos de execução, enquanto políticas e bindings determinam onde cada réplica deve permanecer durante a operação normal, falha e recuperação.
04
Distribuição Inicial
A aplicação NGINX foi configurada com duas réplicas e uma PropagationPolicy utilizando weighted replica scheduling.
Durante a operação normal, o Karmada distribuiu as duas réplicas entre os member clusters, mantendo uma instância da aplicação em cada ambiente.
karmada-member1
1 réplica da aplicação NGINX executando no primeiro member cluster.
karmada-member2
1 réplica da aplicação NGINX executando no segundo member cluster.
A distribuição 1 + 1 confirmou o comportamento esperado da política de scheduling: duas réplicas desejadas, distribuídas entre dois clusters Kubernetes independentes.
05
Cluster Failover
A indisponibilidade do karmada-member2 foi simulada para validar o comportamento de failover da aplicação.
Após detectar a falha, o Karmada recalculou o ResourceBinding e direcionou as duas réplicas para o cluster saudável, preservando a quantidade desejada da aplicação.
karmada-member1
2 réplicas da aplicação passaram a executar no cluster que permaneceu saudável.
karmada-member2
Indisponível durante a simulação de falha, deixando de receber workloads.
Mesmo com um dos clusters indisponível, o Karmada preservou as 2 réplicas desejadas, realocando o workload para o member cluster que permaneceu saudável.
06
Recovery & Rebalancing
Após a recuperação do karmada-member2, ambos os clusters voltaram ao estado saudável. A recuperação do cluster, entretanto, não implica automaticamente a restauração da distribuição original das réplicas.
Para solicitar um novo scheduling do workload, foi utilizado um WorkloadRebalancer, permitindo ao Karmada recalcular a distribuição e restaurar o estado inicial da aplicação.
karmada-member1
Retornou para 1 réplica após o rebalanceamento do workload.
karmada-member2
Após a recuperação, voltou a receber 1 réplica da aplicação.
O retorno do cluster restaurou sua disponibilidade, enquanto o WorkloadRebalancer provocou um novo scheduling para restabelecer a distribuição original de 1 réplica por cluster.
07
Fluxo Validado
O laboratório validou o ciclo completo do workload, desde sua distribuição inicial até o failover, recuperação do member cluster e posterior rebalanceamento das réplicas.
1 + 1 → Falha do
member2 → Failover
2 + 0 → Recovery do
member2 → Rebalancing
1 + 1
01 · Scheduling
O Karmada distribuiu inicialmente uma réplica da aplicação para cada member cluster.
02 · Failure Detection
A indisponibilidade do member2 foi detectada e considerada pelo control plane no cálculo do workload.
03 · Failover
O ResourceBinding foi recalculado e as duas réplicas foram direcionadas ao member1 saudável.
04 · Recovery
O member2 retornou ao estado saudável e voltou a ficar disponível como destino para workloads.
05 · Rebalancing
O WorkloadRebalancer solicitou um novo scheduling após a recuperação do cluster.
06 · Estado restaurado
A aplicação retornou à distribuição original, mantendo uma réplica saudável em cada cluster.
O teste demonstrou que o workload pode atravessar um cenário de indisponibilidade de cluster mantendo a quantidade desejada de réplicas e, após a recuperação, retornar à distribuição original por meio de um novo scheduling.
08
Resultados
O laboratório permitiu validar, de ponta a ponta, o comportamento do Karmada na distribuição e recuperação de workloads executados em múltiplos clusters Kubernetes.
O cenário demonstrou que o Karmada consegue coordenar scheduling, failover e recuperação de workloads entre múltiplos clusters, preservando o estado desejado da aplicação durante o ciclo completo do teste.
09
Tecnologias
O laboratório foi construído com tecnologias cloud-native e ferramentas utilizadas para criação, administração e validação do ambiente Kubernetes multi-cluster.
Orquestração
Kubernetes v1.37
Karmada v1.19
Containers & Clusters
Docker
Kind
NGINX
Administração
kubectl
karmadactl
Ambiente
PowerShell
WSL2
A combinação de Kubernetes, Karmada e clusters locais com Kind permitiu reproduzir um cenário multi-cluster completo em ambiente de laboratório, incluindo scheduling, failover, recovery e rebalancing de workloads.
10
Projeto no GitHub
O laboratório foi documentado para permitir a reprodução do cenário multi-cluster e a análise das configurações utilizadas durante os testes de scheduling, failover, recovery e rebalancing.
Manifests
Recursos Kubernetes e políticas utilizadas para distribuir o workload entre os member clusters.
Failover
Configurações e documentação utilizadas durante a validação da indisponibilidade de um dos clusters.
Arquitetura
Documentação do ambiente multi-cluster e dos componentes utilizados no laboratório.
Reprodução
Estrutura do projeto para estudo e reprodução do laboratório em um ambiente Kubernetes local.
Explore o laboratório completo
Consulte o código, os manifests e a documentação técnica do Karmada Multi-Cluster Lab no GitHub.